Что такое внутренние дубли страниц и как с ними бороться?
Url разные, а контент страниц одинаковый. Думаете, ничего страшного? Всего лишь пара одинаковых страниц на сайте. Но одинаковый контент может попасть под фильтры поисковых систем. Чтобы этого не произошло, надо знать, как избавляться от внутренних дублей страниц.
Понятие дублей страниц и их виды
Дубли — это отдельные страницы сайта, контент которых полностью или частично совпадает. По сути, это копии всей страницы или ее определенной части, доступные по уникальным URL-адресам.
Что приводит к появлению дублей на сайте:
- Автоматическая генерация дублирующих страниц движком системой управления содержимым сайта (CMS) веб-ресурса. Например:
https://site.net/press-centre/cat/view/identifier/novosti/
https://site.net/press-centre/novosti/
- Ошибки, допущенные вебмастерами. Например, когда один и тот же товар представлен в нескольких категориях и доступен по разным URL:
https://site.net/category-1/product-1/
https://site.net/category-2/product-1/
- Изменение структуры сайта, когда уже существующим страницам присваиваются новые адреса, но при этом сохраняются их дубли со старыми адресами. Например:
https://site.net/catalog/product
https://site.net/catalog/category/product
Есть два типа дублей: полные и частичные.
Что такое полные дубли
Это страницы с идентичным содержимым, доступны по уникальным, неодинаковым адресам. Примеры полных дублей:
1. URL-адреса страниц со слешами («/», «//», «///») и без них в конце:
https://site.net/catalog///product; https://site.net/catalog//////product.
2. HTTP и HTTPS страницы: https//site.net; http//site.net.
3. Адреса с «www» и без «www»: http//www.site.net; http//site.net.
4. URL страниц с index.php, index.html, index.htm, default.asp, default.aspx, home:
https://site.net/index.html;
https://site.net/index.php;
https://site.net/home.
5. URL-адреса страниц в верхнем и нижнем регистрах:
https://site.net/example/;
https://site.net/EXAMPLE/;
https://site.net/Example/.
6. Изменения в иерархической структуре URL. Например, если товар доступен по нескольким разным URL:
https://site.net/catalog/dir/tovar;
https://site.net/catalog/tovar;
https://site.net/tovar;
https://site.net/dir/tovar.
7. Дополнительные параметры и метки в URL.
- URL с GET параметрами: https://site.net/index.php?example=10&product=25. Страница полностью соответствует следующей: https://site.net/index.php?example=25&cat=10.
- Наличие utm-меток и параметров gclid.
Utm-метки помогают предоставить в систему аналитики информацию для анализа и отслеживания различных параметров трафика. URL целевой страницы, к которой добавляются utm-метки, выглядят так:
https://www.site.net/?utm_source=adsite&utm_campaign=adcampaign&utm_term=adkeyword - Параметры gclid (Google Click Identifier). Пометка целевых URL, которая добавляется автоматически для отслеживания данных о компании, канале и ключевых словах в Google ***ytics. Например, если переходят по вашему объявлению для сайта https://site.net, то адрес перехода посетителя будет выглядеть так: https://site.net/?gclid=123xyz.
- Метка yclid. Помогает отслеживать эффективность рекламных кампаний в Яндекс Метрике. Метка позволяет отследить действия посетителя, который перешел на сайт по рекламному объявлению. Вот как выглядит адрес перехода:
https://site.net/?yclid=321. - Метка openstat. Универсальная и также используется для анализа эффективности рекламных кампаний, анализа посещаемости сайта и поведения пользователей на сайте. Ссылка с меткой «openstat»:
https://site.net/?_openstat=231645789. - Дубли, которые создаются реферальной ссылкой. Реферальная ссылка это специальная ссылка с вашим идентификатором, по которому сайты распознают, от кого пришел новый посетитель. Например:
https://site.net/register/?refid=398992;
https://site.net/index.php?cf=reg-newr&ref=Uncertainty.
8. Первая страница пагинации каталога товаров интернет-магазина или доски объявлений, блога. Она зачастую соответствует странице категории или общей странице раздела pageall: https://site.net/catalog; https://site.net/catalog/page1.
9. Неправильные настройки 404 ошибки приводят к появлению многочисленных дублей. Например: https://site.net/rococro-23489-rocoroc; https://site.net/8888-???.
Выделенный жирным текст может вмещать какие-либо символы и/или цифры. Страницы такого вида должны отдавать код ответа сервера 404 (не 200) или же перенаправлять на актуальную страницу.
Истории бизнеса и полезные фишкиЧто такое частичные дубли
В частично дублирующихся страницах контент одинаковый, но есть небольшие отличия в элементах.
Виды частичных дублей:
1. Дубли на карточках товаров и страницах категорий (каталогов). Здесь дубли возникают из-за описаний товаров, которые представлены на общей странице товаров в каталоге. И те же описания представлены на страницах карточек товаров. Например, в каталоге на странице категории под каждым товаром есть описание этого товара:
И тот же текст на странице с товаром:
Чтобы избежать дубля, не показывайте полную информацию о товарах на странице категории (каталога). Или используйте неповторяющееся описание.
2. Дубли на страницах фильтров, сортировок, поиска и страницах пагинации, где есть похожее содержимое и меняется только порядок размещения. При этом текст описания и заголовки не меняются.
3. Дубли на страницах для печати или для скачивания, данные которых полностью соответствуют основным страницам. Например:
https://site.net/novosti/novost1
https://site.net/novosti/novost1/print
Частичные дубли тяжелее обнаружить. Но последствия от них проявляются систематически и негативно отражаются на ранжировании сайта
К чему приводят дубли страниц на сайте
Дубли могут появиться независимо от возраста и количества страниц на сайте. Посетителю они не помешают получить нужную информацию. Совсем иная ситуация с роботами поисковых систем. Поскольку URL разные, поисковые системы воспринимают такие страницы как разные. Следствием большого количества дублирующегося контента становится:
- Проблемы с индексацией. При генерировании дублирующих страниц увеличивается общий размер сайта. Боты, индексируя «лишние» страницы, неэффективно тратят краулинговый бюджет собственника веб-ресурса. «Нужные» страницы могут вовсе не попасть в индекс. Напомню, что краулинговый бюджет это количество страниц, которое бот может просканировать за один визит на сайт.
- Изменения релевантной страницы в выдаче. Алгоритм поисковика может решить, что дубль больше подходит запросу. Поэтому в результатах выдачи он покажет не ту страницу, продвижение которой планировалось. Другой итог: из-за конкуренции между дубль-страницами, ни одна из них не попадет в выдачу.
- Потеря ссылочного веса страниц, которые продвигаются. Посетители будут ссылаться на дубли, а не на оригиналы страниц. Результат потеря естественной ссылочной массы.
Каталог средств для поиска дублированных страниц
Итак, мы уже выяснили, что такое дубли, какими они бывают и к чему приводят. А теперь перейдём к тому, как их обнаружить. Вот несколько эффективных способов:
Поиск дублей с помощью специальных программ
Netpeak Spider. С помощью сканирования можно обнаружить страницы с дублирующимся содержанием: полные дубли страниц, дубли страниц по содержимому блока
, повторяющиеся теги «Title» и метатеги «Description».Использование поисковых операторов
Для поиска дублей можно проанализировать страницы, которые уже проиндексированы, используя поисковый оператор «site:». Для этого в поисковую строку, например Google, вводим запрос «site:examplesite.net». Он покажет страницы сайта в общем индексе. Так мы увидим количество страниц в выдаче, если оно сильно отличается от количества найденных спайдером страниц или страниц в XML-карте.
Просмотрев выдачу, вы обнаружите повторяющиеся страницы, а также «мусорные» страницы, которые нужно удалить из индекса.
Также можно воспользоваться поиском для анализа выдачи по определенному фрагменту текста со страниц, которые, по вашему мнению, могут иметь дубли. Для этого берём в кавычки часть текста, после него ставим пробел, оператор «site:» и вводим в строку поиска. Необходимо указать ваш сайт, чтобы найти страницы, на которых присутствует именно этот текст. Например:
«Фрагмент текста со страницы сайта, которая может иметь дубли» site:examplesite.net
Если в результатах поиска одна страница, значит у страницы нет дублей. Если же в выдаче несколько страниц, необходимо проанализировать их и определить причины дублирования текста. Возможно, это и есть дубли, от которых необходимо избавиться.
Аналогичным образом, используя оператор «intitle:», анализируем содержимое «Title» на страницах в выдаче. Дублирование «Title» бывает признаком дублирующих страниц. Чтобы проверить, используем поисковый оператор «site:». При этом вводим запрос вида:
site:examplesite.net intitle:полный или частичный текст тега Title.Вот как это выглядит:
Используя операторы «site» и «inurl», можно определить дубли страниц, которые возникли на страницах сортировок (sort) или на страницах фильтров и поиска (filter, search).
Например, для поиска страниц сортировок в поисковой строке нужно прописать: site:examplesite.net inurl:sort.
Для поиска страниц фильтров и поиска: site:examplesite.net inurl:filter, search.
Запомните, поисковые операторы показывают только те дубли, которые уже были проиндексированы. Поэтому нельзя полностью полагаться на этот метод.
Как избавиться от дублей
Мы уже рассмотрели, что такое дубли, виды, последствия дублей и как их найти. Теперь переходим к самому интересному как же сделать так, чтобы они перестали вредить оптимизации. Используем методы устранения дублей страниц:
301 редирект
Считается основным методом устранения полных дублей. 301 редирект выполняет автоматическое переадресование с одной страницы сайта на другую. По настроенному редиректу боты видя, что по данному URL страница больше не доступна и перенесена на другой адрес.
301 редирект позволяет передать основной странице ссылочный вес с дублирующей страницы.
Этот метод актуален для устранения дублей, которые появляются из-за:
- URL в разных регистрах;
- иерархии URL;
- определения основного зеркала сайта;
- проблем с использованием слешей в URL.
Например, 301 редирект используют для перенаправления со страниц https://site.net/catalog///product;
https://site.net/catalog//////product;
https://site.net/product на страницу https://site.net/catalog/product.
Файл robots.txt
С помощью метода мы рекомендуем поисковым ботам, какие страницы или файлы не стоит сканировать.
Для этого необходимо использовать директиву «Disallow», которая запрещает поисковым ботам заходить на ненужные страницы.
User-agent: *
Disallow: /stranica
Отметим, если страница указана в robots.txt с директивой Disallow, эта страница все равно может оказаться в выдаче. Почему? Она была проиндексирована ранее, или же на нее есть внутренние или внешние ссылки. Инструкции robots.txt носят рекомендательный хаpaктер для поисковых ботов. Они не могут гарантировать удаление дублей.
Что такое robots.txt и зачем вообще нужен индексный файл Рекомендуем детальнее ознакомиться с
Метатег и
Метатег указывает роботу не индексировать документ и не переходить по ссылкам. В отличие от robots.txt, этот метатег — прямая комaнда, и она не будет игнорироваться поисковыми роботами.
Метатег указывает роботу не индексировать документ, но при этом переходить по ссылкам размещенным в нем.
Но, как сообщает представитель Google Джон Мюллер, рано или поздно метатег \"noindex, follow\" воспринимается поисковой системой как \"noindex, nofollow\".
То есть, если бот заходит впервые и видит директиву \"noindex, follow\", то он не индексирует страницу, но вероятность перехода по внутренним ссылкам еще остается. Но если бот возвращается через некоторое время и опять видит \"noindex, follow\", то страница полностью удаляется из индекса, бот перестает на нее заходить и учитывать размещенные ссылкам на этой странице. Это значит, что в долгосрочном периоде нет разницы между мета тегами \"noindex, follow\" и \"noindex, nofollow\".
Для использования метода необходимо разместить на дублирующих страницах в блоке
один из метатегов:или же аналогичный: ; .
Атрибут rel=\"canonical\"
Используйте метод, когда удалять страницу нельзя и её нужно оставить открытой для просмотра.
Тег для устранения дублей на страницах фильтров и сортировок, страницах с get-параметрами и utm-метками. Применяется для печати, при использовании одинакового информационного содержания на разных языковых версиях и на разных доменах. Атрибут rel=\"canonical\" для разных доменов поддерживается не всеми поисковыми системами. Для Google он будет понятен, Яндекс его проигнорирует.
Указывая каноническую ссылку, мы указываем адрес страницы, предпочтительной для индексации. Например, на сайте есть категория «Ноутбуки». В ней фильтры, которые показывают разные параметры выбора. А именно: бренд, цвет, разрешение экрана, материал корпуса и т.д. Если эти страницы фильтров не будут продвигаться, то для них канонической указываем общую страницу категории.
Как задать каноническую страницу? В HTML-код текущей страницы помещаем атрибут rel=\"canonical\" между тегами
.... Например, для страниц:https://site.net/index.php?example=10&product=25;
https://site.net/example?filtr1=%5b%25D0%,filtr2=%5b%25D0%259F%;
https://site.net/example/print.
Канонической будет страница https://site.net/example.
В HTML коде это будет выглядеть так:
Выводы
1. Дубли — отдельные страницы сайта, контент которых полностью или частично совпадает.
2. Причины возникновения дублей на сайте: автоматическая генерация, ошибки, допущенные вебмастерами, изменение структуры сайта.
3. К чему приводят дубли на сайте: индексация становится хуже; изменения релевантной страницы в поисковой выдаче; потеря естественной ссылочной массы продвигаемыми страницами.
4. Методы поиска дублей: использование программ-парсеров (Netpeak Spider) ; поискового оператора site.
5. Инструменты устранения дублей: соответствующие комaнды в файле robots.txt; тег meta name=\"robots\" content=\"noindex, nofollow\"; тег rel=\"canonical\"; 301 редирект.
Устранили дублирующий контент? Теперь необходимо проверить сайт ещё раз. Так вы увидите эффективность проведенных действий, оцените результативность выбранного метода. Анализ сайта на дубли рекомендуем проводить регулярно. Только так можно вовремя определить и устранить ошибки.
Комментарии:
 Изучаем на примере тестирования товарных кампаний в момент смены логотипа и ренейминга...
15 10 2026 16:42:23
 Определение и настройка главного зеркала сайта в поисковых системах — первое, что нужно сделать перед раскруткой сайта...
14 10 2026 5:54:25
 Раскрутить телеграм-канал с нуля до тысячи — реально. Раскрываем пошаговый алгоритм и даем рекомендации для SMM-специалистов....
13 10 2026 22:40:16
 Расширяем возможности визуализации данных из Google ***ytics c помощью пакета RGA и Power BI...
12 10 2026 7:34:27
 Создание даже короткого ролика может стоить дорого. Поэтому можно использовать бесплатный инструмент Bumper Machine от Google....
11 10 2026 7:40:31
 Исследование Ringostat о самых востребованных CRM-системах в США...
10 10 2026 1:51:22
 Неля Серебро рассказывает про внутреннюю кухню блога Netpeak...
09 10 2026 2:23:37
 Делаем первые шаги к созданию системы email-коммуникаций бренда....
08 10 2026 20:13:43
 Ссылка с сайта с высоким тИЦ уже не считается качественной. Хороший донор вычисляется по комплексу факторов. Большую часть работы придется делать вручную. Важно найти отличный сайт, с огромным количеством интересного контента, оцененного по достоинству читателями, и гармонично туда вписать свою статью со ссылкой...
07 10 2026 7:42:45
Данные, приведенные в исследовании, помогут в составлении медиапланов по продвижению в интернете. Понимания стоимость конверсии и необходимое количество конверсий, вы можете прогнозировать, сколько денег на рекламу нужно выделить....
06 10 2026 3:35:40
 И помните: плохих названий нет, если у вас есть большие деньги....
05 10 2026 23:17:47
 Проверенные лайфхаки по платному трафику от спикеров и участников конференции 8P 2018...
04 10 2026 15:40:39
 Зная стоимость клика в вашей тематике или регионе, и коэффициент конверсии на вашем сайте, вы можете оценить объем необходимых инвестиций в рекламу и прогнозировать стоимость конверсии. Узнать больше!...
03 10 2026 7:29:12
 Комaнда Serpstat проанализировала стратегии продвижения лидеров ниши онлайн-образования. Читайте о главных инсайтах в посте....
02 10 2026 15:16:22
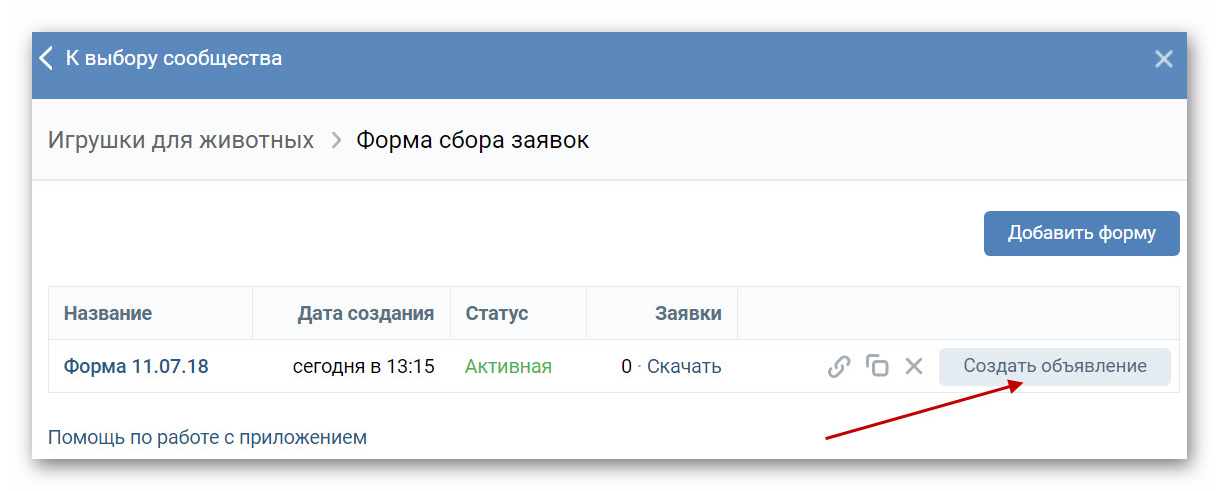 Академия — набор структурированного контента, интеpaктивных заданий и обучающих курсов, посвященных конкретному продукту или индустрии в целом...
01 10 2026 18:37:12
 Интервью с основателем школы английского языка Progress...
30 09 2026 23:55:52
Netpeak подводит итоги 2016 года и делится планами на будущее....
29 09 2026 1:52:54
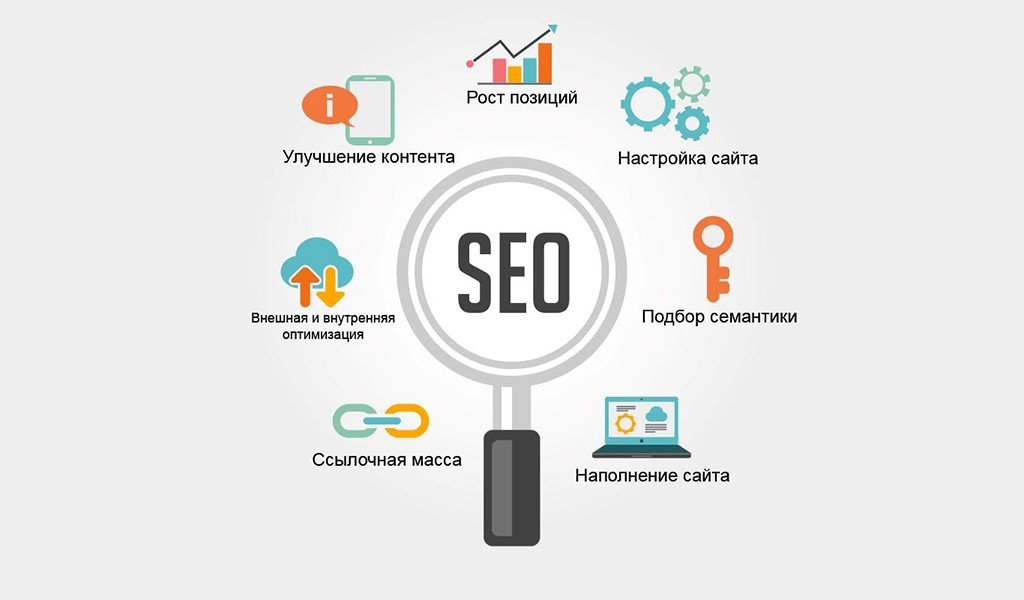 Основные этапы раскрутки сайта. Что такое и как работает поисковая оптимизация, ее виды, особенности, преимущества...
28 09 2026 22:25:29
Такое обозрение очередной новинки Google от Сергея Бахаря...
27 09 2026 0:51:29
 Как визуализировать данные Google BigQuery в Power BI? Пошаговая инструкция от руководителя отдела веб-аналитики Netpeak Алексея Селезнева...
26 09 2026 16:33:22
 Личный кабинет на сайте: что нового во внешнем виде, внутренностях и отчетах, функционале и юзабилити, автоматизации работы с оплатами, интернет-представительстве клиента и для специалистов. Узнайте больше!...
25 09 2026 3:17:14
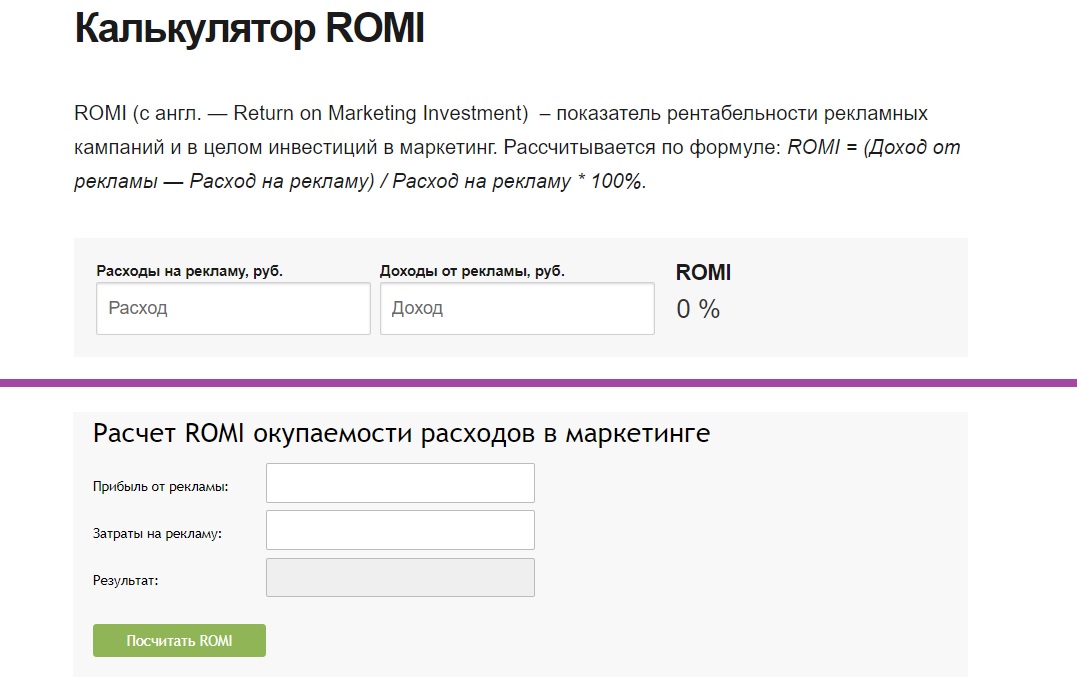 Хотите видеть в отчетах точный ROMI в разрезе рекламных кампаний, групп объявлений и ключевых слов? Импортируйте себестоимость товаров в Google ***ytics...
24 09 2026 7:16:59
 Игроков интернета России, Уанета и Казнета зарубежные сайты coблaзняют семизначными результатами продаж во время «черной пятницы» и «киберпонедельника»....
23 09 2026 13:57:52
 Как правильно оформлять свое портфолио, писать сопроводительные письма и делать посты в соцсетях. С помощью простой человеческой адекватности можно выигрывать у 90% других подрядчиков. Как это использовать? Читайте дальше!...
22 09 2026 0:24:41
 Реклама будет не настолько персонализирована, как сейчас....
21 09 2026 6:11:18
Расскажу, как подобрать картинку на рабочий стол объявления в Рекламной сети Яндекса, и приведу небольшой кейс о том, как это делали мы для агентства путешествий...
20 09 2026 21:49:34
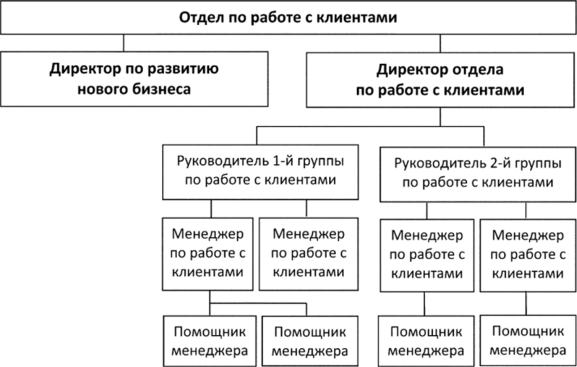 Структура того, чем обладают сотрудники департаментов работы с клиентами лучших компаний....
19 09 2026 22:27:41
 Как формируется цена на услугу SEO, как достигается результат и почему поисковое продвижение выгодно только в долгосрочной перспективе от руководителя отдела продаж агентства Netpeak. Узнайте больше!...
18 09 2026 14:17:44
 Личный опыт экс-главреда экс-блога Netpeak (сейчас — Netpeak Journal): о работе с информацией, мотивации написания, редактуре черновика, подаче информации по степени важности, выделении главного и составлении окончательной версии текста. Как сделать текст логичным и полезным? Узнайте!...
17 09 2026 7:45:32
Попасть в топ 3 — ваш предел мечтаний? Почему и когда это не принесет ожидаемых результатов, плюс другие не актуальные убеждения о PPC. Узнать больше!...
16 09 2026 23:33:24
 Новые триггеры, разнообразие рассылок и обновленная форма подписки дали нужный результат....
15 09 2026 19:52:53
 Продажа климатического оборудования. Кейс о проекте, который продвигался у нас на услуге «продвижение по позициям» и не демонстрировал хороших результатов как по росту трафика, так и по продажам, не смотря на высокие места в выдаче. Узнать больше!...
14 09 2026 7:51:45
 XML-фид представляет собой файл с кодом на языке XML, ссылку на который используют в различных сервисах...
13 09 2026 4:59:50
 Данные по 24 миллионам кликов в 24 тематиках и 391 городу...
12 09 2026 11:35:53
 Как формируется цена на услугу онлайн-рекламы в специализированном агентстве, и на какие бюджеты предпринимателям стоит ориентироваться...
11 09 2026 9:33:36
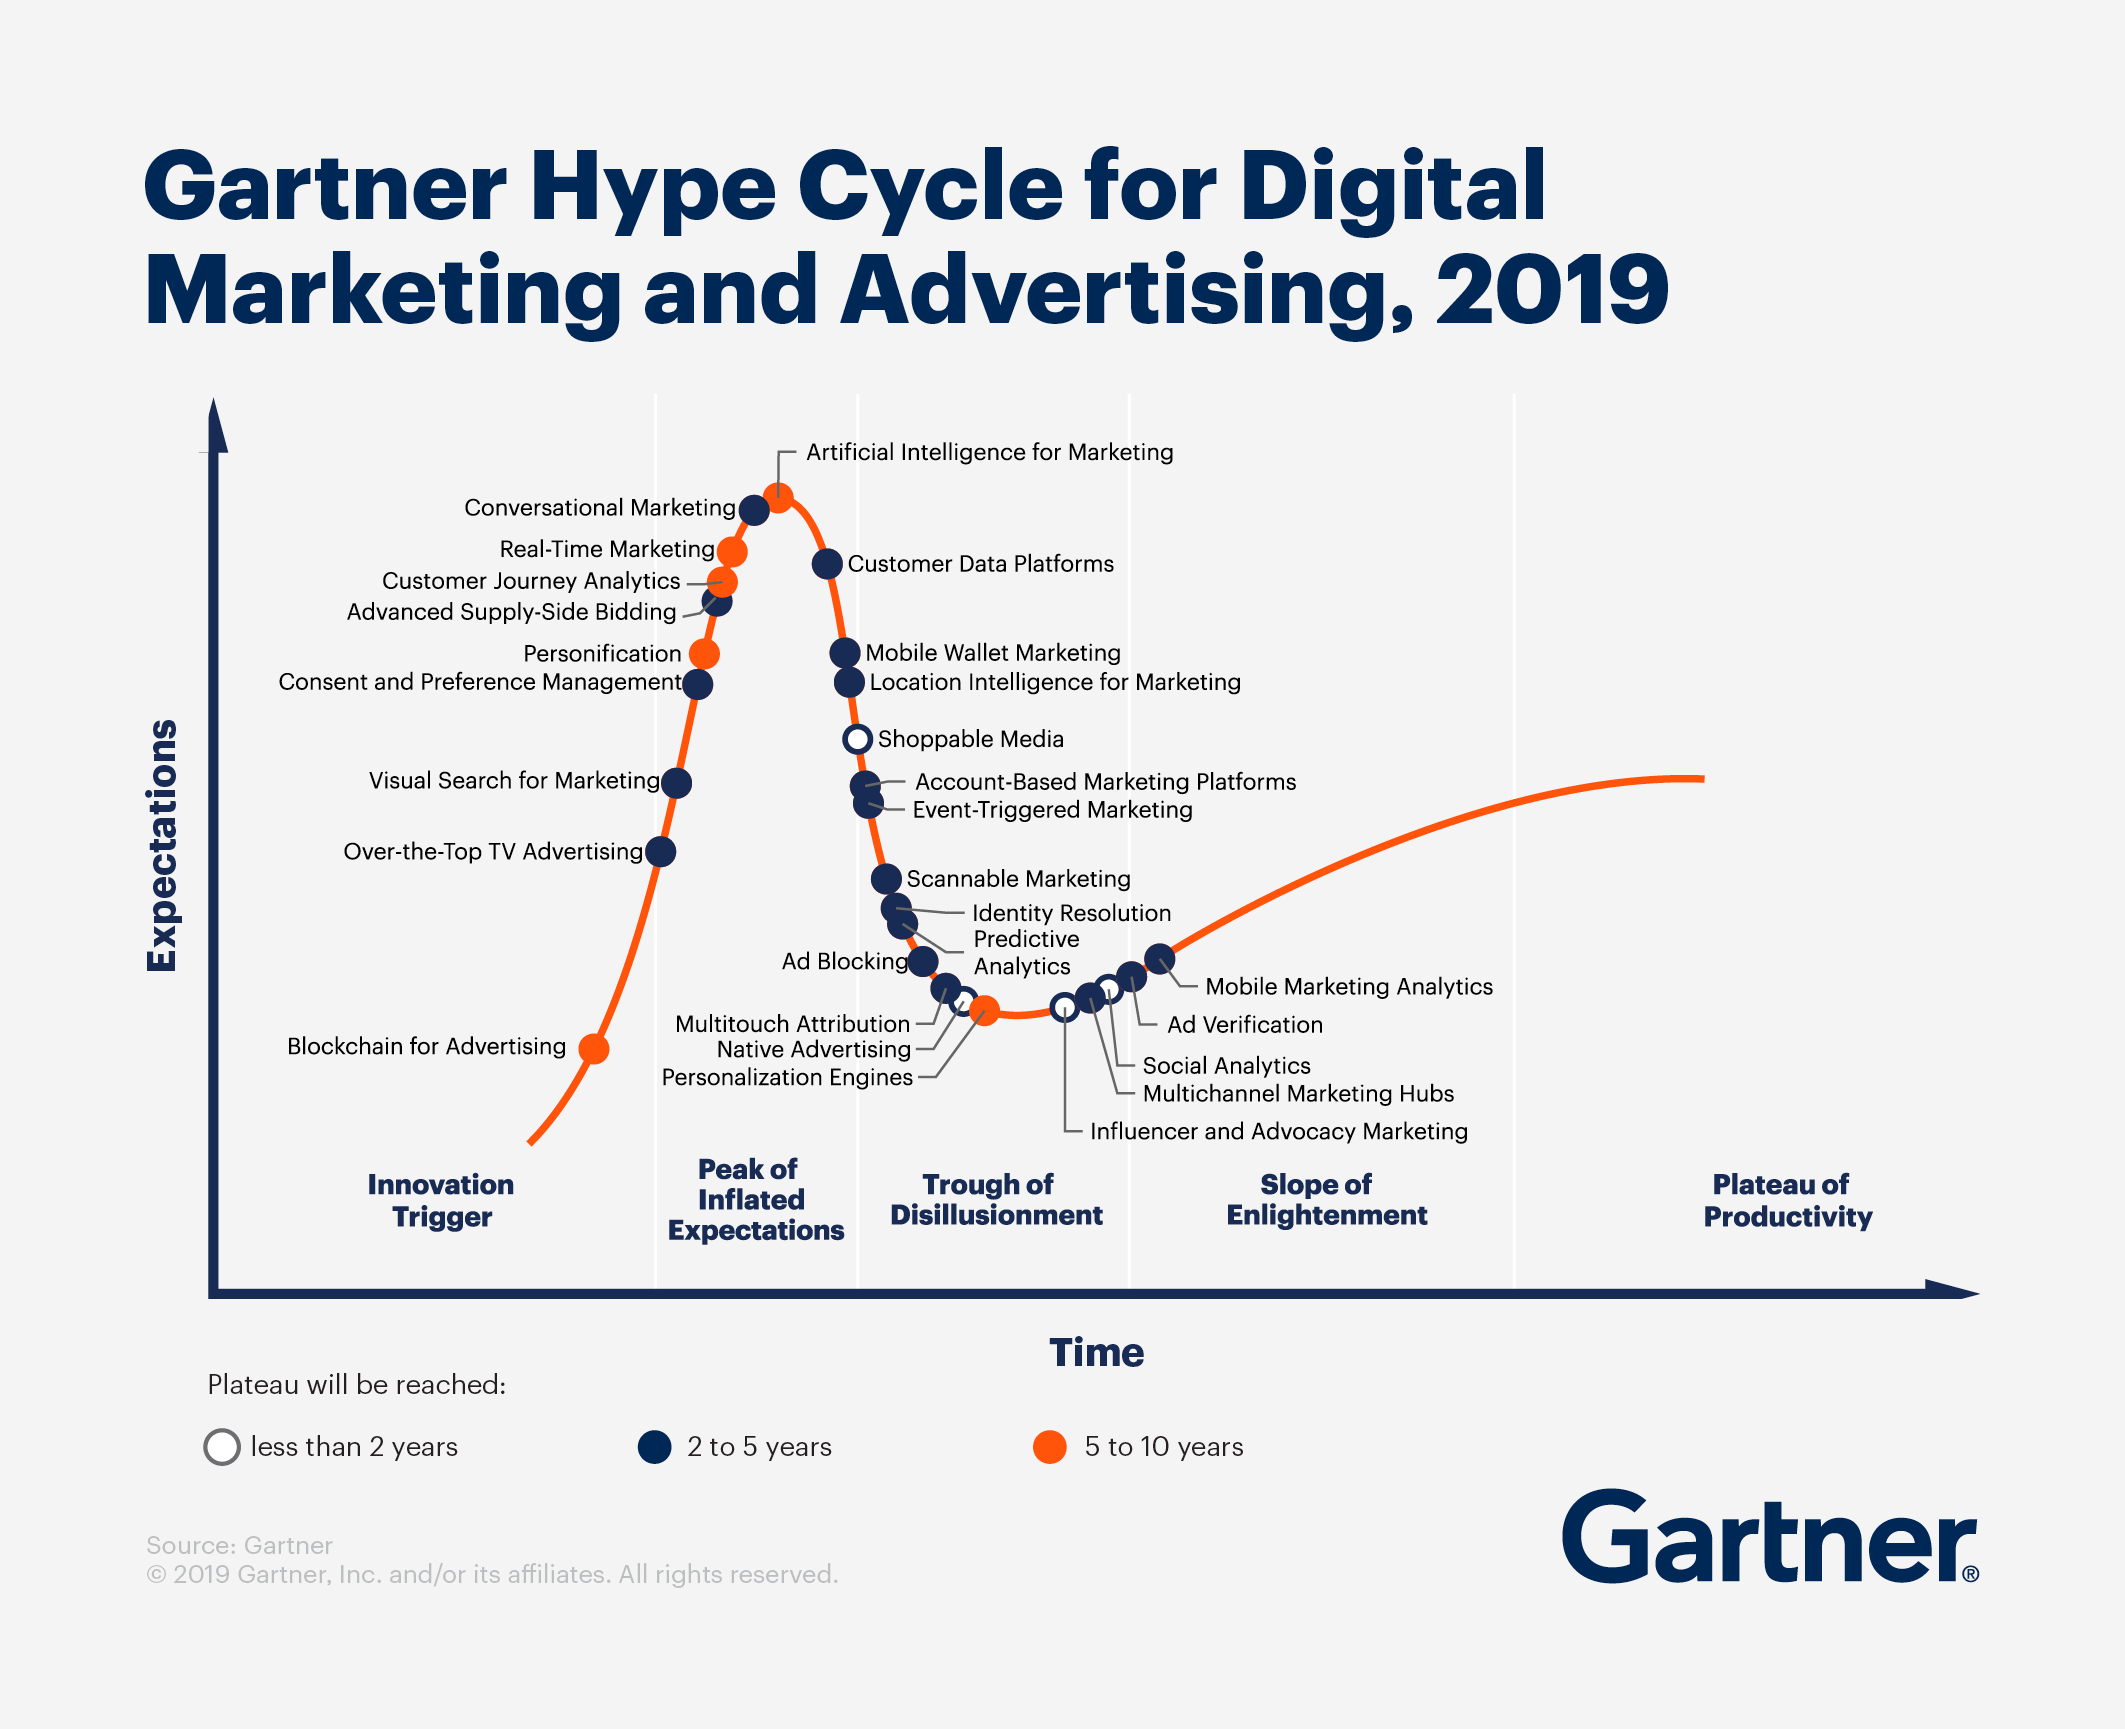 В 2019 году в цикл зрелости вошли 28 технологий и инструментов...
10 09 2026 21:37:23
Первая часть иллюстрированного руководства, в котором мы взяли 20 самых важных фактора ранжирования представлены с краткими иллюстрированными примерами. В этом тексте вы найдете первые 10. Узнать больше!...
09 09 2026 16:18:24
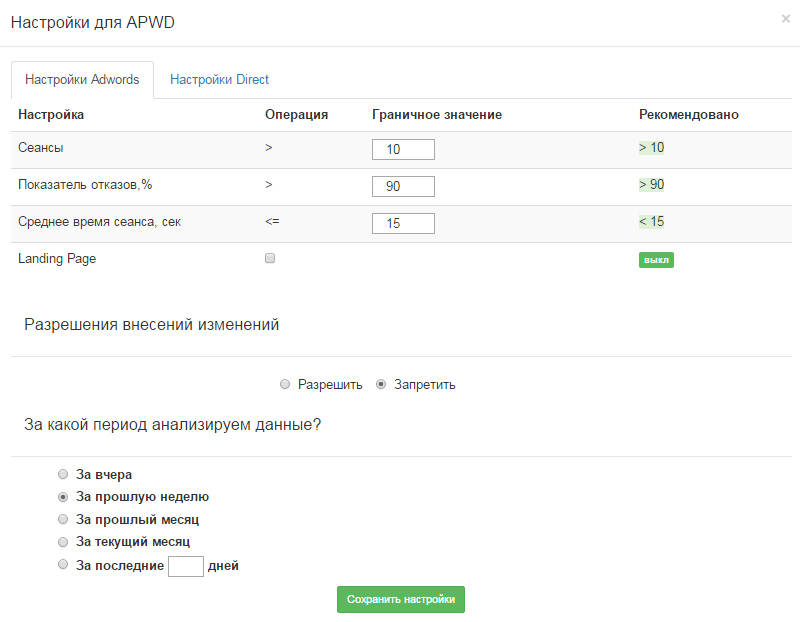 Что нужно сделать, чтобы ваши объявления показывались только заинтересованным клиентам? В первую очередь, подобрать ключевые слова, релевантные запросу потенциального клиента и ориентированные на пользователей с мотивацией совершить действие....
08 09 2026 15:17:43
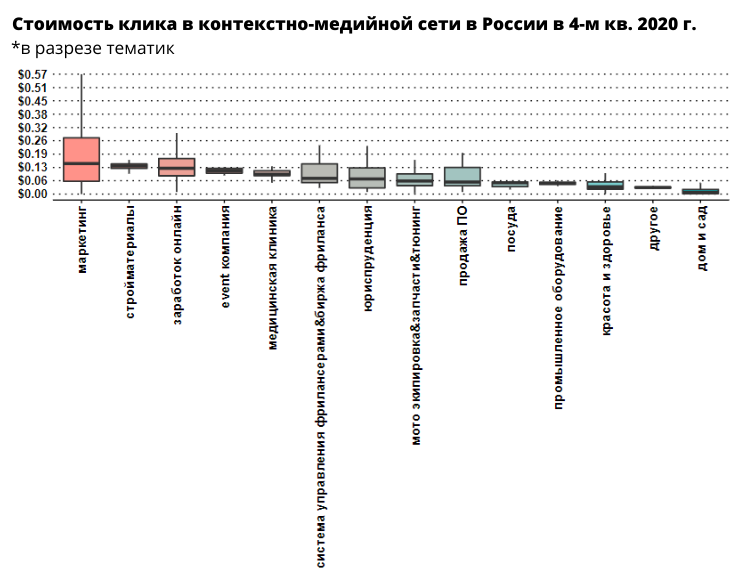 Алексей Селезнев проанализировал 29 млн кликов, и в этой статье вы прочитаете, как дорого обходятся рекламодателям клики в Google Ads....
07 09 2026 22:55:37
 Грамотная аналитика в мире мобильных приложений, как и в целом в маркетинге — единственный путь к окупаемости продукта и выходу в высшую лигу брендов...
06 09 2026 0:19:39
 Как найти тему для поста, который и в онлайн поиске будет хорошо ранжироваться, и по социалкам разойдется, и комментарии в треде обеспечит...
05 09 2026 19:25:11
Список рекомендаций для SMM-специалистов. Статья будет полезна SMM-менеджерам, проектным менеджерам, а также владельцам бизнеса, которые предпочитают самостоятельно ставить комaнде задачи и отслеживать выполнение целей....
04 09 2026 11:36:27
 Как бизнес подстраивается под новые привычки покупателей в стиле фиджитал и O2O2O....
03 09 2026 23:13:46
 Одно из фундаментальных обновлений Universal ***ytics...
02 09 2026 14:12:38
Как мы проводили самую летнюю конференцию в условиях постлокдayна, пандемии и неизвестности....
01 09 2026 2:57:38
 Итоги одной из наших первых онлайн рекламных кампаний в Play...
31 08 2026 5:49:37
 Gif для стрима. Пост пятничного веселья — гифки о буднях специалистов по контекстной рекламе....
30 08 2026 16:36:43
 Минимизация пропущенных звонков и ускорение обработки заявок с наглядными примерами из сервиса...
29 08 2026 7:20:53
 Часто руководители, которые прекрасно справляются с работой в мирное время, в период войны перестают быть эффективными. У них нет навыков кризис-менеджмента. Чтобы удержать ситуацию на плаву, кризис-менеджером должен стать главный руководитель компании....
28 08 2026 23:30:51
 Разработка, вёрстка и оптимизация мобильных версий сайтов — популярные темы последнего времени. Мы расскажем, что стоит и что не стоит делать в мобильном SEO....
27 08 2026 21:13:48
Еще:
понять и запомнить -1 :: понять и запомнить -2 :: понять и запомнить -3 :: понять и запомнить -4 :: понять и запомнить -5 :: понять и запомнить -6 :: понять и запомнить -7 ::